なぜAIが爆発的に進化したのか?なぜデータセンター投資競争になったのか?

なぜAIが爆発的に進化したのか?
2020年、「AIに大量のデータと計算資源(コンピューターのパワー)を投入すると、性能が予測可能な形で向上し続ける」という法則が論文で示され、実際にAIの性能が爆発的に向上しました。
OpenAIが示した「スケーリング則」の衝撃
2020年、OpenAIの研究チームは「Scaling Laws for Neural Language Models」という画期的な論文を発表しました。
この論文で示されたのは、以下の3つの要素を大きくすればするほど、AIの性能(予測の正確さ)が予測可能な形で向上し続けるという事実でした。
①モデルサイズ AIの「脳」の大きさ・パラメータ数
②データ量 AIが学習する文章・画像などの量
③計算量 学習に使うコンピューターの処理量
ここで大事なのは、この関係が「比例」ではなく「べき乗則」だということです。
論文によれば、学習に使う計算量を大幅に増やしても、言語モデルの損失は緩やかにしか改善しません
AIは、少し性能を上げるために膨大な計算資源が必要があります。
つまり、スケーリング則は「投資すればするほど効率が落ちていく(収穫逓減)」法則でもあるのです。
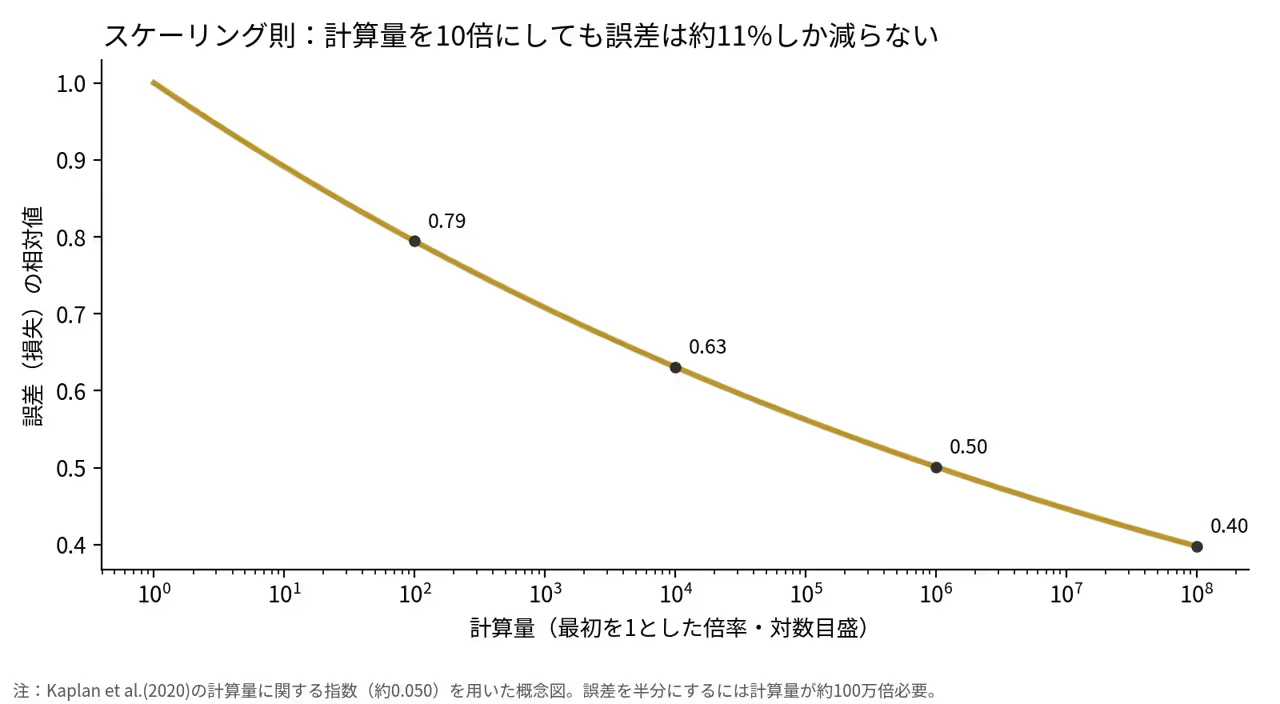
それでも各社が投資をやめないのは、誤差のわずかな低下が、実際の能力では文章作成、翻訳、プログラミングなどの「できること」の大きな飛躍として現れるからです。
ここに「わずかな改善に莫大な投資が必要」という構造があり、これがデータセンター開発競争の本質です。
OpenAI自身もこの法則に従ってGPT-3(2020年)やGPT-4(2023年)を開発し、その圧倒的な性能で世界を驚かせました。
それまでは「ある程度データを入れても、どこかで頭打ちになるのではないか」と思われていました。
(実際には2017年に米百度(Baidu)の研究チームが「深層学習の性能向上は規模に応じて予測可能」とする論文を出しており、OpenAIは最初の発見者ではなく、それを大規模に体系化・実証した存在です。)
しかし、OpenAIは「投資を増やせば増やすほど、AIは賢くなり続ける」ことを実際に示したのです。
誰も言っていないけれど大切なことがあります。
この論文の著者には、ジャレド・カプラン氏とダリオ・アモデイ氏が含まれています。
2人はその後OpenAIを離れ、2021年にAnthropic(Claudeの開発元)を共同創業しました。
スケーリング則を示した当事者が、後に「データ不足」に直面して紙の本の大量スキャンに踏み切ることになります。
この点は後半で触れます。
巨大データセンター開発競争の引き金
これによりスケーリングローの正しさが広く信じられるようになり、他社も「データセンターを巨大化させる以外に生き残る道はない」と確信するに至りました。
これが現在の巨大データセンター開発競争の決定的な引き金になりました。
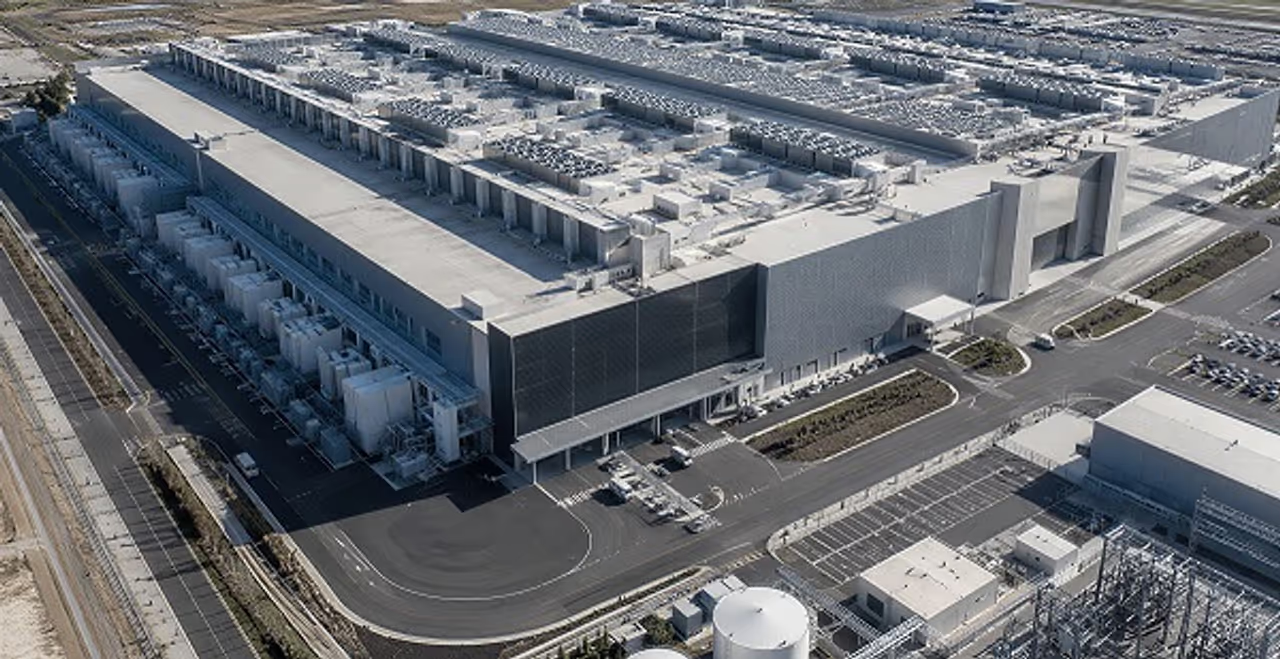
「データを大量に入れれば性能が予測どおりに良くなる(そしてそれは投資額に応じて続く)」というOpenAIの発見が、現在のデータセンター開発競争の理論的・実践的なベースになっています。
なお、スケーリング則は物理法則のように証明されたものではなく、実験から見つかった経験則です。
2022年にはGoogle傘下DeepMindの「チンチラ論文」が、OpenAIの当初の結論を修正し、「モデルを大きくするだけでなく、データ量も同じ割合で増やすべき」と示しました。
この修正が、後のデータ枯渇問題につながっていきます。
「投資すれば必ず勝てる」という計算
この法則が広く信じられたことで、テック企業にとってAI開発は「暗中模索のギャンブル」から「お金をかけた分だけ確実にリターンが得られる設備投資」へと変わったと考えられるようになりました。
・他社より賢いAIを作るには、他社より多くの計算資源が必要になる。
・計算資源を確保するには、最先端のAI半導体(NVIDIAのGPUなど)を何万枚も並べなければならない。
・それを動かすには、膨大な電力と巨大な敷地(データセンター)が必要になる。
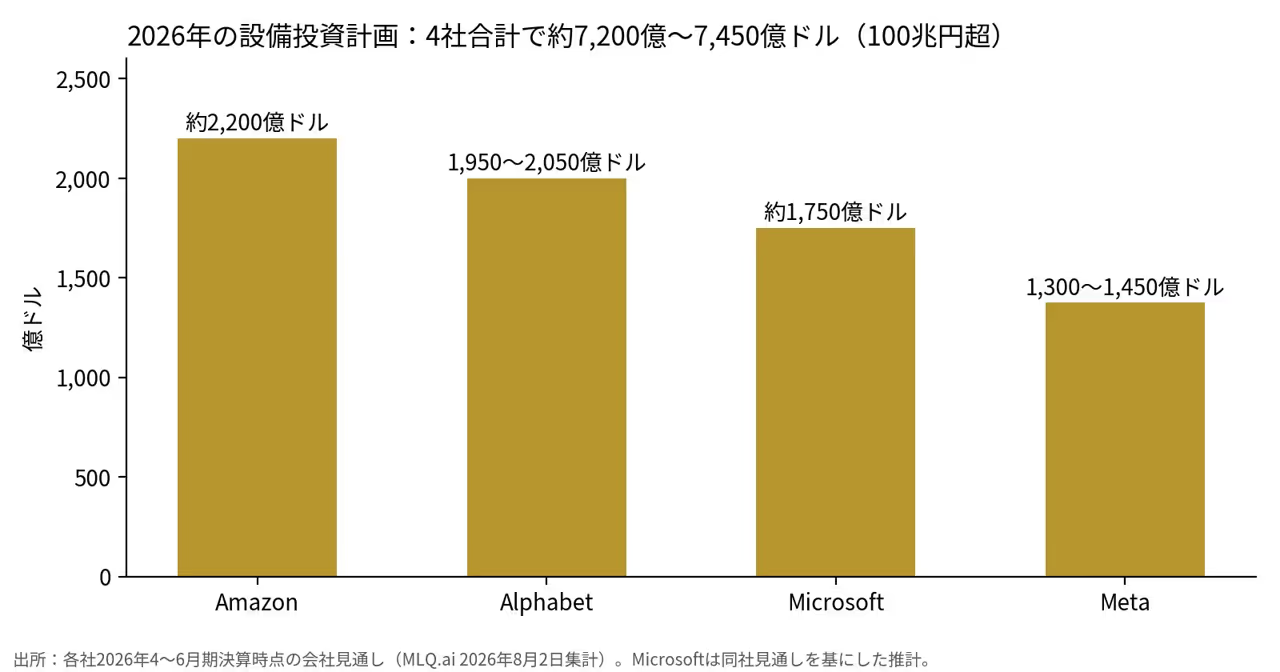
このロジックにより、Microsoft、Google、Meta、Amazonなどのメガテック企業による、年間100兆円を超えるデータセンター建設ラッシュが始まりました。
4社の設備投資計画は、2026年に合計約7,200億〜7,450億ドルと、前年からほぼ倍増する見通しです。
一方で、この前提を疑う声もあります。
2024年秋には、OpenAI共同創業者のイリヤ・サツケバー氏が「事前学習の規模拡大による成果は頭打ちになりつつある」と述べたと報じられました。
2025年1月には中国のDeepSeekが、米大手よりはるかに少ない計算資源で高性能なAIを開発したと発表し、米国のAI関連株が急落しました。
「AI性能向上には際限なく計算資源が必要なのか」という議論を加速させました。
AI企業は現在、学習の規模だけでなく「推論時にAIに長く考えさせる」という新しい方向でも性能を伸ばそうとしています。
「投資すれば必ず勝てる」は業界の信念であって、保証された事実ではありません。
「ハイパースケーラー」という言葉は、スケーリング則の登場より前の2010年代から使われていました。
需要に応じてシステムや設備を際限なく巨大に拡張できる設計思想「ハイパースケール・コンピューティング(Hyperscale computing)」に由来し、もともとはクラウドを支える巨大データセンターを運営する企業を指す言葉です。
AIブームによって、その意味と存在感が一気に大きくなりました。
読み込ませるデータの枯渇
AIに大量のデータを読み込ませることが性能向上に必須なので、各社大量のデータを読み込ませてきました。
その結果、現在、インターネット上のテキストデータだけではAIの成長に必要なデータが不足する「データ枯渇問題」が世界的に深刻化しています。
AI研究機関Epoch AIの研究(2024年)によれば、人間が書いた質の高い公開テキストは約300兆トークン(単語の断片)で、現在のペースでは2026〜2032年に使い切ると推計されています。
ただし同研究は、AIが作ったデータ(合成データ)や画像・動画の活用、学習効率の改善によって、ある程度は補えるとも指摘しています。
その打開策として、ネット上に存在しない「紙の書籍(特に古い専門書や地方の資料)」に大きな注目が集まっています。
1. 日本の古書の大量購入
日本の古書店での「謎の大量注文」と輸出
日テレNEWS(2026年9月22日)の報道によれば、日本のオンライン古書店において、購入者が特定されていない「機械的な大量注文」が相次いでいます。
送り先は岡山県の物流センターで、AI学習目的ではないかとみられています。
哲学、歴史、医学、法律、さらには「江戸時代の生活・文化」といった、通常の読者なら一度に大量購入しないような古い専門書がターゲットになっています。
同報道では、日本国内で集められた本が、米国へ50トン以上も輸出された記録があるとされています(統計の出典は示されていません)。
2. なぜ「古い紙の本」をわざわざ買うのか?
AI企業が紙の古書を買い集めるのには、法的な背景とデータとしての価値という2つの理由があります。
実際に確認されている例は米国のAnthropicです。
米国の著作権訴訟(Bartz対Anthropic)で公開された資料から、同社が2024年から「プロジェクト・パナマ」と呼ばれる計画で、米国の中古書店などから数百万冊の紙の本を購入し、背表紙を裁断してスキャンし、原本を処分していたことが明らかになりました。
ただし、日本の古書の大量注文とAnthropicを結びつける証拠は、現時点では見つかっていません。
ネットにない「質の高い知識」の宝庫
ネット上のSNSやブログの文章に比べ、古い書籍には校正された正しい日本語や、デジタル化されていない貴重な歴史的・専門的知識が詰まっています。
法律上の位置づけ(原文:著作権や規約の「抜け道」)
電子書籍は「利用規約」でAI学習が禁止されていることが多いですが、紙の書籍を購入して自分でデジタル化(自炊)する行為は、米国の裁判所が適法と判断しています。
2025年6月、米連邦地裁のアルサップ判事は「正規に購入した紙の本をスキャンしてAIの学習に使うことは、フェアユース(公正な利用)にあたる」と判断しました。
一方で、海賊版サイトから集めた本の利用は認められず、Anthropicは約48万作品を対象に総額15億ドル(1冊あたり約3,000ドル)を著者に支払う和解に至りました(2026年7月に最終承認、米国史上最大の著作権和解)。
日本では、著作権法30条の4によって、AIの学習のために著作物を利用することは、著作権者の利益を不当に害する場合を除いて原則として認められています。
つまり「抜け道」というよりも、「正規に買った本なら合法」「海賊版は違法」という線引きがこの事件では明確になったことで、紙の本の買い占めが進んだと考えるのが正確です。
そのため、本を丸ごと買い占める動きが進んでいます。
3. 文化的な損失への懸念と議論
これらの古書は、海外の施設などで背表紙を裁断してスキャンされ、データ化されたあとに原本が廃棄されるケースがあり(Anthropicの米国での事例)、これが「文化資産の破壊だ」として大きな批判を集めています。
国立国会図書館にすら所蔵されていないような地域の歴史書や自費出版の稀少本が、AIのデータになる代わりにこの世から物理的に消滅してしまうリスクが懸念されています。
(なお、日本の古書が同様に裁断・廃棄されたかどうかは現時点で確認されていません。これは「起きたこと」ではなく「起こり得るリスク」です。)
投資家が見るべきポイント
「最近急激にAIが賢くなった理由」と
「巨額なデーターセンター投資競争になっている理由」が分かったと思います。
今、世界では「AIにいくらお金を使えるか」という競争が起きています。
しかし、AIの性能を決めるものは計算資源だけではありません。
データの質、学習方法、推論の仕組み。
そして、いかに少ない資源で高い性能を実現できるか。
もしここで大きな技術革新が起きれば、現在の巨額なデータセンター投資の価値そのものが変わる可能性があります。
そこで、今、投資家が見るべきなのは、
「AI市場が伸びるかどうか」だけではありません。
「AIが伸びたとき、いったい誰が一番儲かる構造になっているのか」
AI投資の勝者が変わる可能性があるということです。
つまり「AIが伸びる」と「今のAI関連企業が儲かる」は同じ話ではありません。
ここを見極めることが、これから非常に重要になってくると思います。
そのための基本の注目点は以下の通りです。
①巨額投資に見合う利益を出せるのか
②スケーリングはどこまで続くのか
③データ枯渇はどう解決するのか
④電力は確保できるのか
⑤少ない計算資源で高性能AIを作る技術が出てきたらどうなるのか
変化や気付いた点があれば、イーグルフライやリアルインテリジェンスに書いていきます。
関連記事
参考資料
愛読書が「AIのエサ」に?数百万冊の本が裁断・廃棄されている件の何が問題なのか(Yahoo!ニュース エキスパート)
日テレNEWS「古書店で『謎の大量注文』相次ぐ……AI学習か 米国向け『日本の本 50トン』の輸出記録も」(2026年9月22日)
Kaplan et al.「Scaling Laws for Neural Language Models」(2020年)
Hestness et al.「Deep Learning Scaling is Predictable, Empirically」(2017年)
Hoffmann et al.「Training Compute-Optimal Large Language Models」(チンチラ論文、2022年)
Villalobos et al.「Will we run out of data?」(Epoch AI、2024年)
MLQ.ai「Big Tech's 2026 Capex Range Reaches $720 Billion to $745 Billion」(2026年8月2日)
Statista「Big Tech's AI Spending to Reach $760 Billion in 2026」
Reuters「OpenAI and rivals seek new path to smarter AI as current methods hit limitations」(2024年11月11日、Investing.com掲載)
DeepSeek-AI「DeepSeek-V3 Technical Report」(2024年12月)
Wikipedia「Hyperscale computing」
Washington Post「Anthropic 'destructively' scanned millions of books」(2026年1月27日)
Wikipedia「Project Panama」
Wiggin and Dana「Bartz v. Anthropic: First Court Decision on Fair Use Defense in LLM Training」
JURIST「Judge approves record $1.5 billion AI copyright settlement involving Anthropic」(2026年7月)
文化庁「AIと著作権について」
投資に関する注意事項
本サイト(本情報)は、情報提供のみを目的として作成されたものであり、特定の金融商品への投資を勧誘するものではありません。
掲載されている情報は、正確性や完全性を保証するものではなく、予告なしに変更・削除されることがあります。
また、過去の実績は将来の運用成果を保証するものではありません。
投資に関する最終決定は、お客様ご自身の判断と責任において行っていただけますようお願いいたします。
本情報に基づいて被ったいかなる損害についても、当方は一切の責任を負いかねますのであらかじめご了承ください。
各講師のオンラインサロンや有料サービスもございます。詳しくは商品一覧ページをご確認ください。